⚠️ 注意: AI画像生成時は著作権・肖像権にご注意ください。商用利用前には各サービスの利用規約をご確認ください。当ブログは生成された画像に関する責任を負いかねます。
📝 本記事にはアフィリエイトリンクが含まれています。
要約
- Fish Audio の新しい読み上げモデル「Drama 3」が、2026年10月13日に Comfy のパートナーノードで使えるようになりました。Comfy Cloud で、日本語のセリフを実際に生成して聞き比べてみました
- 指示を何も書かなくても、セリフから想像できる感情がこもった読み方になり、日本語の発音もしっかりしていました。
[驚いて][ささやくように]のような演技指導を書くと、文の途中で話し方を切り替えたり、<whisper>でささやかせたりできます - 「笑う」のような感情の名前だけを書くと、笑いが浮くことがありました。なぜ笑うのかまで書くと、狙いに近づきます
- 2人の掛け合い(6行・31秒)も1回で生成でき、消費は約4クレジットでした
はじめに
2026年10月13日、Fish Audio が新しい読み上げモデル「Drama 3」を発表しました。同じ日に Comfy のパートナーノードにも入っていて、ComfyUI から使えるようになっています。
告知には「1つの会話として複数キャラの場面を書いて、ワークフロー1本で音声にできる」とありました。正直、僕は読み上げ(TTS)のモデルをほとんど触ったことがなくて、何に使うものなのかもピンときていなかったんです。そこで、まずは日本語のセリフを読ませて聞き比べるところから試してみました。
結果から言うと、指示なしでもちゃんと感情が乗っていて、日本語の発音もしっかりしていたことに一番驚きました。演技指導を書けば、文ごとに話し方を変えることもできます。一方で、指示の書き方によっては不自然になるところもあったので、その直し方もあわせてまとめます。
試した環境
| 項目 | 内容 |
|---|---|
| 日時 | 2026年10月14日 |
| 環境 | Comfy Cloud |
| ノード | Fish Audio Text to Speech(model: drama-3) |
| 声 | Fish Audio Voice Selector のプリセット(日本語の声) |
| 設定 | temperature 0.7 / top_p 0.7 / speed 1.0(すべて既定値) |
Comfy の Drama 3 紹介ページ。使い方や料金がまとまっています
Fish Audio Drama 3とは
Fish Audio Drama 3 は、Fish Audio が開発した読み上げ(Text to Speech)モデルです。文章を読ませるだけでなく、「泣きそうに」「早口で」のような演技の指示を本文の中に書き込んで、声の演技を付けられるのが特徴です。
公式発表によると、主な特徴は次のとおりです。
- 演技指導: 角括弧
[ ]の中に、話し方の指示を普通の言葉で書く。指示は次の指示まで続き、行の途中に書けばそこで切り替わる - 単語ごとの指示:
<whisper>…</whisper>のようにタグで囲んだ部分だけ読み方を変える - 効果音的な発声:
[laugh][sigh][pause]のように、笑い声・ため息・間を入れる - 複数の話者: 1つの台本で、話者を切り替えながら読ませる
- 多言語: 日本語を含む83言語に対応。指示はセリフと違う言語で書いてもよい
前のモデル「S2.1 Pro」よりも感情表現が豊かになったとされていて、読み間違いやすい単語・数字の正答率は 93.2%(S2.1 Pro は 88.1%)と公式は発表しています。
モデルの重みも公開されています(Fish Audio Community License)。研究・非商用は無料、年商50万ドル未満なら商用でも無料という条件です。ただ、Comfy のパートナーノードは Fish Audio の API を呼び出す仕組みなので、手元の GPU で動かすわけではありません。
ComfyUIでDrama 3を使う準備
Drama 3 は、パートナーノードの Fish Audio Text to Speech の model で drama-3 を選ぶだけで使えます。ノードはノード一覧の partner/audio/Fish Audio にあります。
custom を選べば、fish.audio で公開されている声の ID も使えます。[指示] を入れます。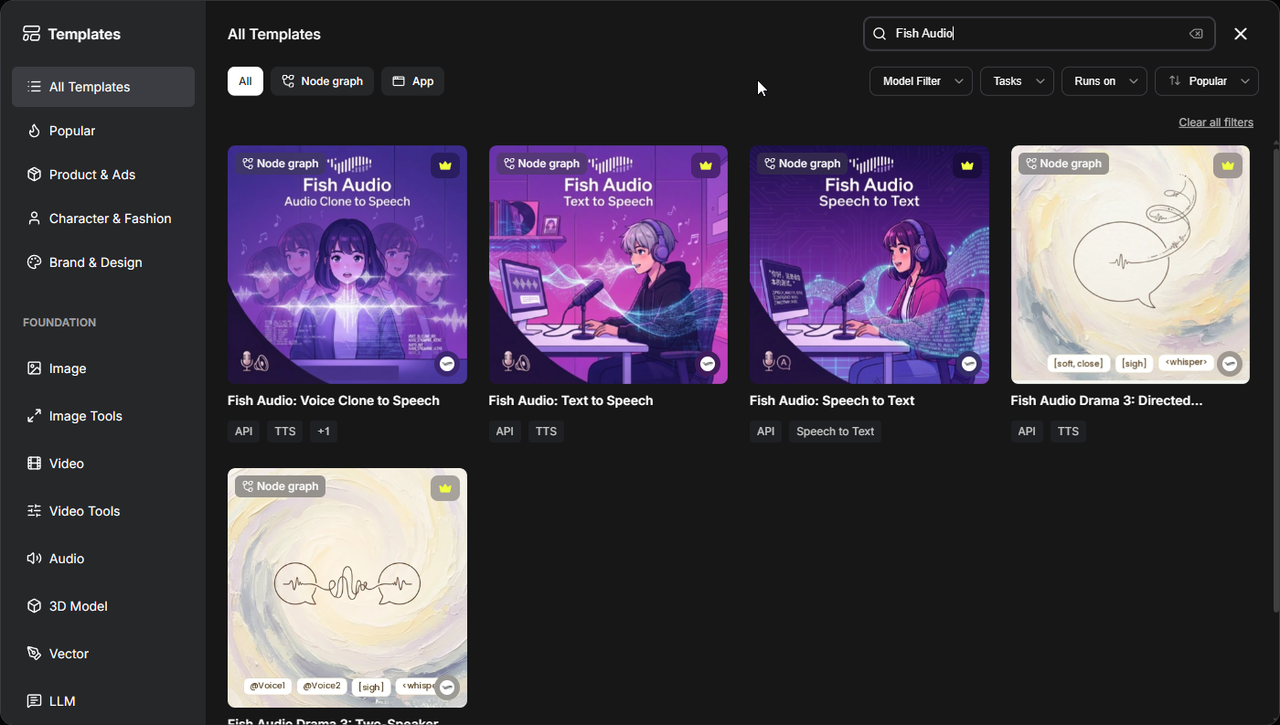
テンプレートを使わずに組む場合は、Voice Selector → Text to Speech → Save Audio とつなぐだけです。
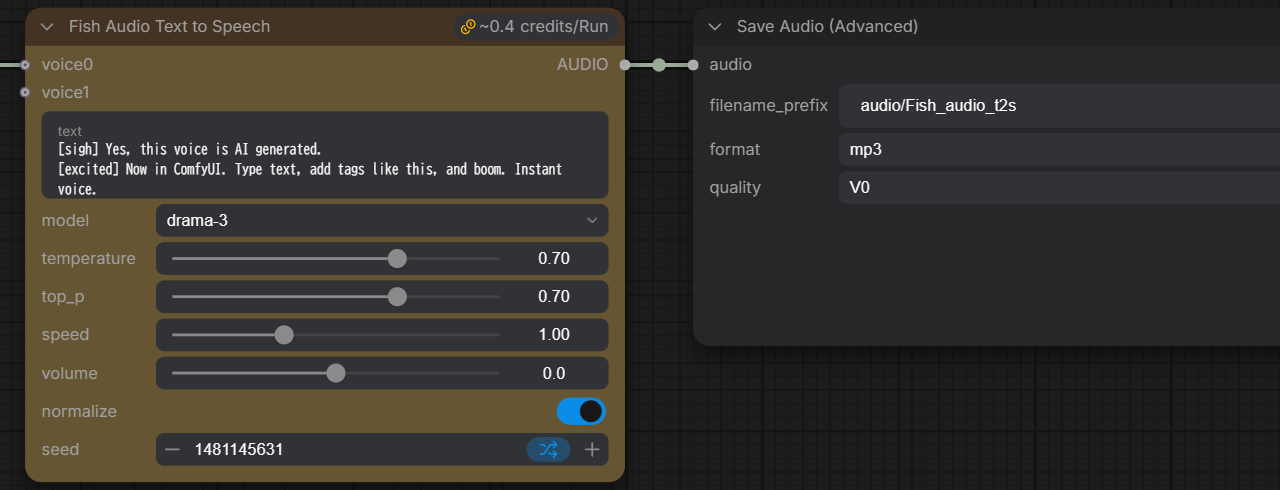
s2.1-pro と s1 しか載っていません。ノードの model の選択肢には drama-3 がすでに入っているので、ノードの方を見てください。指示なしで日本語のセリフを読ませてみた
まずは指示を何も書かずに、同じセリフを前のモデル(s2.1-pro)と Drama 3 で読ませてみました。声はどちらも Energetic Female (ja) です。
セリフは「ずっと待ってたんだよ。来てくれて、ほんとにうれしい。」です。
ずっと待ってたんだよ。来てくれて、ほんとにうれしい。
ずっと待ってたんだよ。来てくれて、ほんとにうれしい。
指示を書いていないのに、セリフから想像できる感情がこもった読み方になっていました。そして何より、日本語がしっかり発音されていることに驚きました。
[演技指導]で感情を付ける
ここからは、セリフの前や途中に [指示] を書いて、話し方を変えてみます。
泣き笑いを指示する(日本語と英語)
さっきと同じセリフに、[涙をこらえながら、無理に笑って] と指示を付けました。英語で [holding back tears, forcing a smile] と書いた版も作っています。
[涙をこらえながら、無理に笑って] ずっと待ってたんだよ。来てくれて、ほんとにうれしい。[涙をこらえながら、無理に笑って] ずっと待ってたんだよ。来てくれて、ほんとにうれしい。
[holding back tears, forcing a smile] ずっと待ってたんだよ。来てくれて、ほんとにうれしい。
指示を入れると、指示なしのときよりも細かい感情表現になりました。指示は日本語でも英語でも受け付けてくれます。
文の途中で話し方を切り替える
1つのセリフの中で、驚き → ささやきに切り替えてみました。指示は、話し方を変えたい位置にそのまま書きます。
[驚いて、思わず大きな声で] えっ、本当に? [声を落として、ささやくように] ……誰にも言っちゃだめだよ。えっ、本当に?……誰にも言っちゃだめだよ。
[驚いて、思わず大きな声で] えっ、本当に? [声を落として、ささやくように] ……誰にも言っちゃだめだよ。
これはまさに狙い通りでした。前半で声が上がって、後半ですっと声がひそまります。指示のおかげで、文ごとに話し方を調整できるのが分かります。
単語だけを強調する
<emphasis> で囲んだ単語だけを強めて、最後に笑い声を入れてみました。
[あきれたように、ため息まじりに] だから言ったじゃん。<emphasis>今日は</emphasis>無理だって。[小さく笑う]だから言ったじゃん。今日は無理だって。
[あきれたように、ため息まじりに] だから言ったじゃん。<emphasis>今日は</emphasis>無理だって。[小さく笑う]
「今日は」の強調は指示通りに付いていました。ただ、最後の笑いが気になったんです。あきれた流れとつながらず、急に面白くなって笑ったように聞こえました。
笑い方が浮いたときの指示の直し方
最後の [小さく笑う] は「笑う」という動作を書いているだけで、どういう気持ちで笑うのかが書かれていません。そもそもこのセリフには、笑う理由が書かれていないんですよね。人が読んでも、場面が分からないと笑い方は決まりません。
そこで、前半はそのままにして、笑いの指示だけを3通りに書き直しました。
| 案 | 指示 | ねらい |
|---|---|---|
| A | 末尾を [しょうがないなあ、という感じで苦笑する] に |
笑う理由を書く |
| B | 末尾を [あきれつつも、ふっと力が抜けたように小さく笑う] に |
前の感情から続けて笑わせる |
| C | 先頭を [あきれたように、ため息まじりに。最後は苦笑い] にして、末尾は [小さく笑う] のまま |
最初に全体の流れを伝えておく |
…無理だって。[しょうがないなあ、という感じで苦笑する]
…無理だって。[あきれつつも、ふっと力が抜けたように小さく笑う]
[あきれたように、ため息まじりに。最後は苦笑い] …無理だって。[小さく笑う]
聞いてみると、3本とも同じ「あきれ」から、別々の気持ちに着地していました。
- A: 「苦笑」と書いたのに、本当に嫌そうなため息に聞こえる
- B: 「そこまで困ってるなら、やらないでもないけど」と、一呼吸置いている感じ
- C: あきれつつも、頼られたのがうれしくて「ふふっ」と笑っている感じ
B は「力が抜ける」という体の動きを書いたぶん、それが間として出ているように感じました。C は普通に笑っているだけかもしれませんが、「頼られてうれしい」という背景を知って聞くと、そう聞こえてくるんです。
ここから分かったのは、次の2つです。
- 「笑う」「苦笑」のような感情の名前だけだと、どう出るかは読めない。 なぜそうなるのか、体がどうなるのかまで書くと狙いに近づく
- 聞く側も、場面を知っているかどうかで受け取り方が変わる。 作った音声を誰かに聞かせるときは、どういう場面なのかを一緒に伝えた方がいい
Drama 3で2人の掛け合いを1回で生成する
告知で一番推されていた、複数話者の掛け合いも試しました。
Text to Speech に Voice Selector を2つつなぐと、台本の中で @Voice1 @Voice2 を使って話者を切り替えられます。書き方は [指示] @Voice1 セリフ の順です。
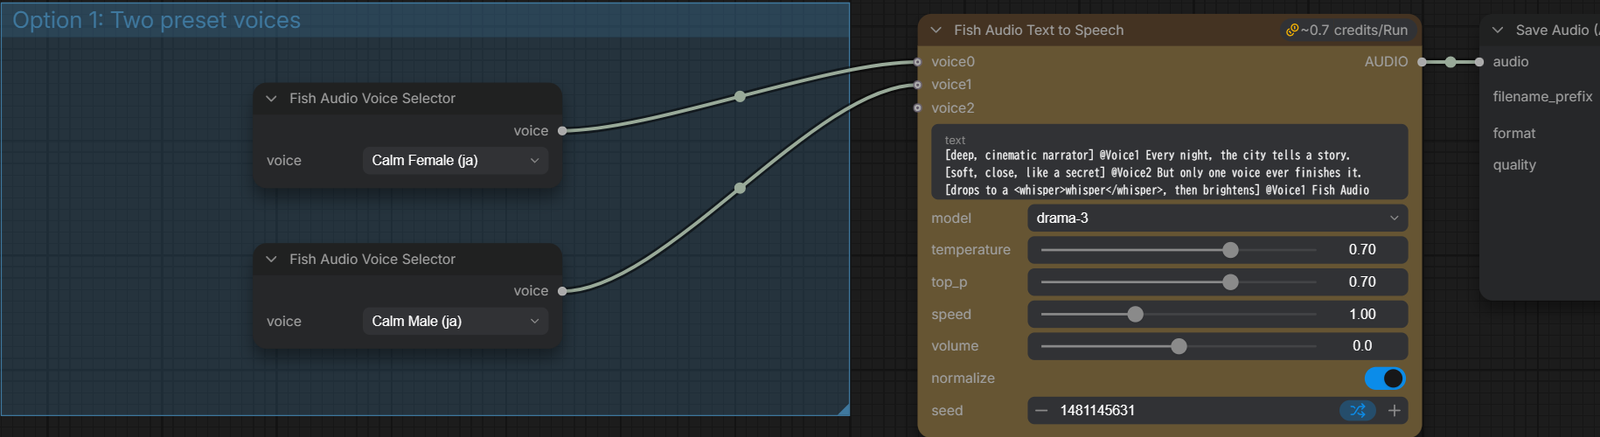
今回は、女の子(Energetic Female (ja))と男の子(Calm Male (ja))の掛け合いにしました。最後の行は、さっきの反省を生かして、笑う理由まで書いています。
[興味しんしんで、少し前のめりに] @Voice1 ねえ、これ本当にAIが読んでるの?
[ちょっと得意げに、でも落ち着いて] @Voice2 そうだよ。セリフの前に、どう読んでほしいかを書くだけなんだ。
[半信半疑で、からかうように] @Voice1 ふーん。じゃあ、泣きながら笑うとかもできるの?
[思い出しながら、少し感心したように] @Voice2 できるよ。さっき試したら、思ったより泣きそうな声になってびっくりしたんだよね。
[驚いて声が上がり、すぐに声をひそめて] @Voice1 えっ、すごい! <whisper>……それ、別の声でもできる?</whisper>
[頼られたのがうれしくて、照れ隠しに小さく笑いながら] @Voice2 しょうがないなあ。今度いっしょにやってみようか。Voice1: Energetic Female (ja) / Voice2: Calm Male (ja)
Voice1 と Voice2 はちゃんと分かれていて、それぞれに書いた話し方もしっかり反映されていました。<whisper> の部分は本当にささやき声になっていて、びっくりしました。6行の掛け合いが、ワークフロー1回で31秒の音声になります。
Drama 3のクレジット消費
この記事のために生成した音声のクレジット消費です。Comfy Cloud の利用履歴(Activity)には、パートナーノードの分(API)と、ワークフローを動かした GPU 時間の分が別々に記録されます。GPU 時間は、公式の単価(1秒あたり 0.266 クレジット)で換算しました。
| 生成したもの | API | GPU 時間 | 合計 |
|---|---|---|---|
| s2.1-pro・1行(3本の平均) | 0.30 | 約2.9秒(0.77) | 1.07 |
| Drama 3・指示なし1行(3本の平均) | 0.20 | 約2.3秒(0.61) | 0.81 |
| Drama 3・指示あり1行(7本の平均) | 0.46 | 約2.5秒(0.66) | 1.12 |
| Drama 3・2人の掛け合い(6行・31秒) | 2.71 | 約4.9秒(1.31) | 4.02 |
※ 2026年10月14日の実測です。ローンチ特典の期間中なので、特典が終わると変わる可能性があります。
1行のセリフなら1クレジット前後、掛け合い1本で約4クレジットでした。この記事の音声をすべて作っても、合計は20クレジットに届いていません。
見ていて気付いたのは、次の3つです。
- 短いセリフでは、GPU 時間の分の方が API の分より大きい。 読み上げだけのワークフローでも、毎回2〜5秒の GPU 時間が記録されていました
- 指示を書くと API の分が増える。 指示の文字も、料金の対象になる文字数に数えられているようです
- 同じセリフでは、Drama 3 の方が s2.1-pro より API の分が少なかった。 ちょうど「Drama 3 が最初の30日間 50% オフ」というローンチ特典の期間中なので、その影響かもしれません(確かめてはいません)
ローンチ特典や料金は紹介ページで確認できます
よくある質問
[ ] も日本語で書けます。custom を選べば、fish.audio で公開されている声の ID も指定できます。まとめ
Fish Audio Drama 3 を Comfy Cloud で試してみた内容をまとめます。
- 2026年10月13日に発表され、同じ日に Comfy のパートナーノードで使えるようになった。Text to Speech ノードの model で
drama-3を選ぶだけ - 指示なしでも、セリフから想像できる感情がこもった読み方になる。日本語の発音もしっかりしている
[指示]を書くと、文の途中で話し方を切り替えたり、<whisper>でささやかせたり、<emphasis>で単語だけ強めたりできる- 笑いのような細かい演技は、感情の名前だけでなく、なぜそうなるのかまで書くと狙いに近づく
@Voice1@Voice2で、2人の掛け合いを1回で生成できる。6行・31秒で約4クレジット
正直、ここまで日本語で演技してくれるとは思っていませんでした。読み上げの使い道がピンときていなかった僕でも、掛け合いを聞いて「動画にセリフを付けるのに使えそう」と思えたので、動画生成と組み合わせることも試してみたいと思います。
関連記事
- Stable Audio 3をComfyUIで使う方法|Small-Music・SFX・Mediumを実際に生成して検証
- ACE-Step 1.5 XL完全ガイド|ComfyUIで使えるAI音楽生成モデルの使い方
- Seedance 2.0をComfyUIで試してみた──I2Vアクション動画の生成手順
- Comfy Agent(ベータ版)を使ってみた──動画ワークフロー構築とクレジット消費の実際
- Comfy Cloudの料金プランの選び方|STANDARDとCREATORの違い
⚠️ AI画像生成をご利用の際の重要な注意事項
著作権・知的財産権について
- 既存のキャラクター、作品、ブランドロゴなどの模倣・複製は著作権侵害にあたる可能性があります
- 商用利用時は特に注意が必要です
肖像権について
- 実在人物(著名人・一般人問わず)の顔や特徴を模倣した画像生成はお控えください
- 無断での肖像権使用は法的トラブルの原因となります
利用規約の確認
- 各AI画像生成サービスの利用規約を必ずご確認ください
- 商用利用の可否、生成画像の権利関係は各サービスで異なります
免責事項
- 当ブログの情報を参考にしたAI画像生成により生じた問題について、当ブログは一切の責任を負いません
- 法的問題が生じた場合は、利用者の自己責任となります
- 最新の法律・規約情報は公式情報をご確認ください
適切なAI画像生成を心がけ、創作活動を楽しみましょう。
詳細についてはAIと著作権についてをご覧ください。
コメント